社内RAGは、小さく始めたほうが安い——検討する順番と、最初にやめるべきこと
社内RAGの相談で最も多いのが「全社の文書を全部入れたい」という出発点です。ですがこれが費用を最も膨らませ、しかもお金をかけた案件ほど使われなくなります。対象を絞る/既存DBを使う/ローカルモデルで試す/権限だけは最初に設計する、という順番と、その理由を書きます。
blog
社内RAGの相談で最も多いのが「全社の文書を全部入れたい」という出発点です。ですがこれが費用を最も膨らませ、しかもお金をかけた案件ほど使われなくなります。対象を絞る/既存DBを使う/ローカルモデルで試す/権限だけは最初に設計する、という順番と、その理由を書きます。
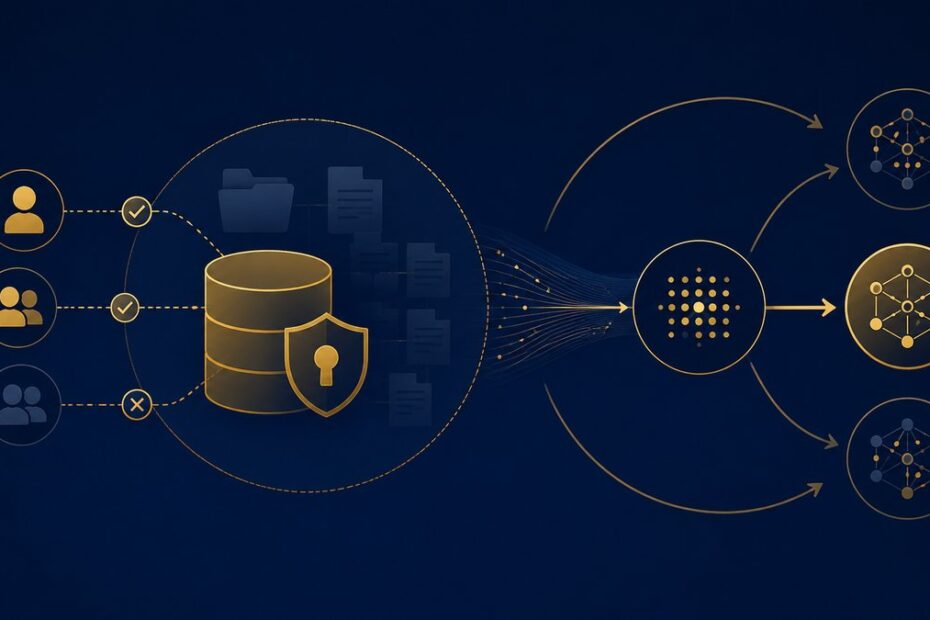
RAGの予算を壊すのは初期費用ではなく「あとで足そう」とした部分です。権限は文書単位ではなくチャンク単位で必要になるため、後から足すと分割からやり直しになります。再計算は数万件で数時間、数十万件で日単位。埋め込みモデルの差し替えも必ず来ます。後から足せるものと足せないものを整理しました。
RAGの実装部分は正確に見積もれます。見積もれないのは、渡される社内文書の状態のほうです。スキャンPDFはOCRより精度検証に時間がかかり、Excelは行と列の関係を文章に組み直す設計が要る。そして「就業規則_最新版(修正)」のような版の重複だけは、技術では解決できません。
社内RAGの相場は「小規模50〜200万円、運用は月5〜50万円」と言われます。ですがこの幅を作っているのは開発工数ではなく構成の選択です。埋め込みをローカル化しpgvectorを使えば追加の固定費は消え、小規模なら30万円台・保守は月1万円から始められます。そして予算を本当に壊すのは、初期費用ではない3つの場所です。
専用のベクトルDBを契約せず、すでに動いているPostgreSQLにpgvectorを入れてRAGを組む構成。次元数が後から変えられない理由、e5系のプレフィックス、HNSWとIVFFlatの選び分け、しきい値をギャップで切る方法、そして最も重い「埋め込みモデルを差し替える日」の入れ替え手順まで、Djangoの実コードで解説します。
ベクトル検索は「意味が近いか」しか見ていないため、閲覧権限のない文書も平気で返してきます。社内RAGが本番直前に必ずぶつかるこの壁を、Django+pgvectorの事前フィルタでどう塞ぐか。後フィルタが破綻する理由、絞り込むと件数が足りなくなるHNSWの罠、そして実装後も残る3つの漏洩経路まで書きます。
「構造化力を身につける方法」という投稿が三十六万回読まれていた。書かれていることは正しい。ただしそれは、大学が四年かけて訓練していることでもある。付け焼き刃の構造化はどこでばれるのか、そして「四年」の正体は何か。
ジョナサン・ハイト『不安の世代』は、2010年前後から10代のメンタルヘルスが一斉に悪化した理由を、遊びを基盤とした子ども時代からスマホを基盤とした子ども時代への組み替えに求めました。4つの害と4つの提言を日本の統計と重ねて整理し、「因果が証明されていない」という批判にどう向き合うべきかまで書きます。

POSII COLUMN Claude Code × Docker Redmin… 続きを読む »Claude Code × Docker Redmine 連携のすすめ ― AIがチケットを読んで、直して、報告してくれる開発環境

POSII COLUMN 抽象化の抽象化 ——一歩引くことが、なぜ発見になるのか… 続きを読む »抽象化の抽象化 ——一歩引くことが、なぜ発見になるのか